強化学習(Reinforcement Learning,RL)を基盤とするLimX Dynamicsの二足歩行ロボット「P1」が、深セン市の郊外公園塘朗山を初めて訪れました。ゼロショット、保護構造なし、完全オープンな環境で「開梱後すぐ稼働」のテストを実施しました。完全に未知の野外環境において、多種多様な複雑な地形を高い動的性能で走破し、強化学習による優れた制御性と安定性を実証しました。
LimX Dynamicsの二足歩行ロボット「P1」、強化学習に基づき野外森林でのハイキングテストを完了
LimX Dynamicsは強化学習分野に長期的な技術蓄積を保有しており、現在は強化学習の最先端技術を体系的な研究開発能力へと転換し、製品機能の開発を支援することに注力しています。独自の強化学習研究開発体系を提唱しており、主に「Real2Sim2Real」クローズドループ、ニューラルネットワークアーキテクチャ設計、データ生成メカニズム及び学習アルゴリズム設計という 3 つの核心分野で構成されています。継続的に最適化されるプロセス管理とアルゴリズム検証を組み合わせることで、ヒューマノイドロボットの重要機能開発を推進しています。
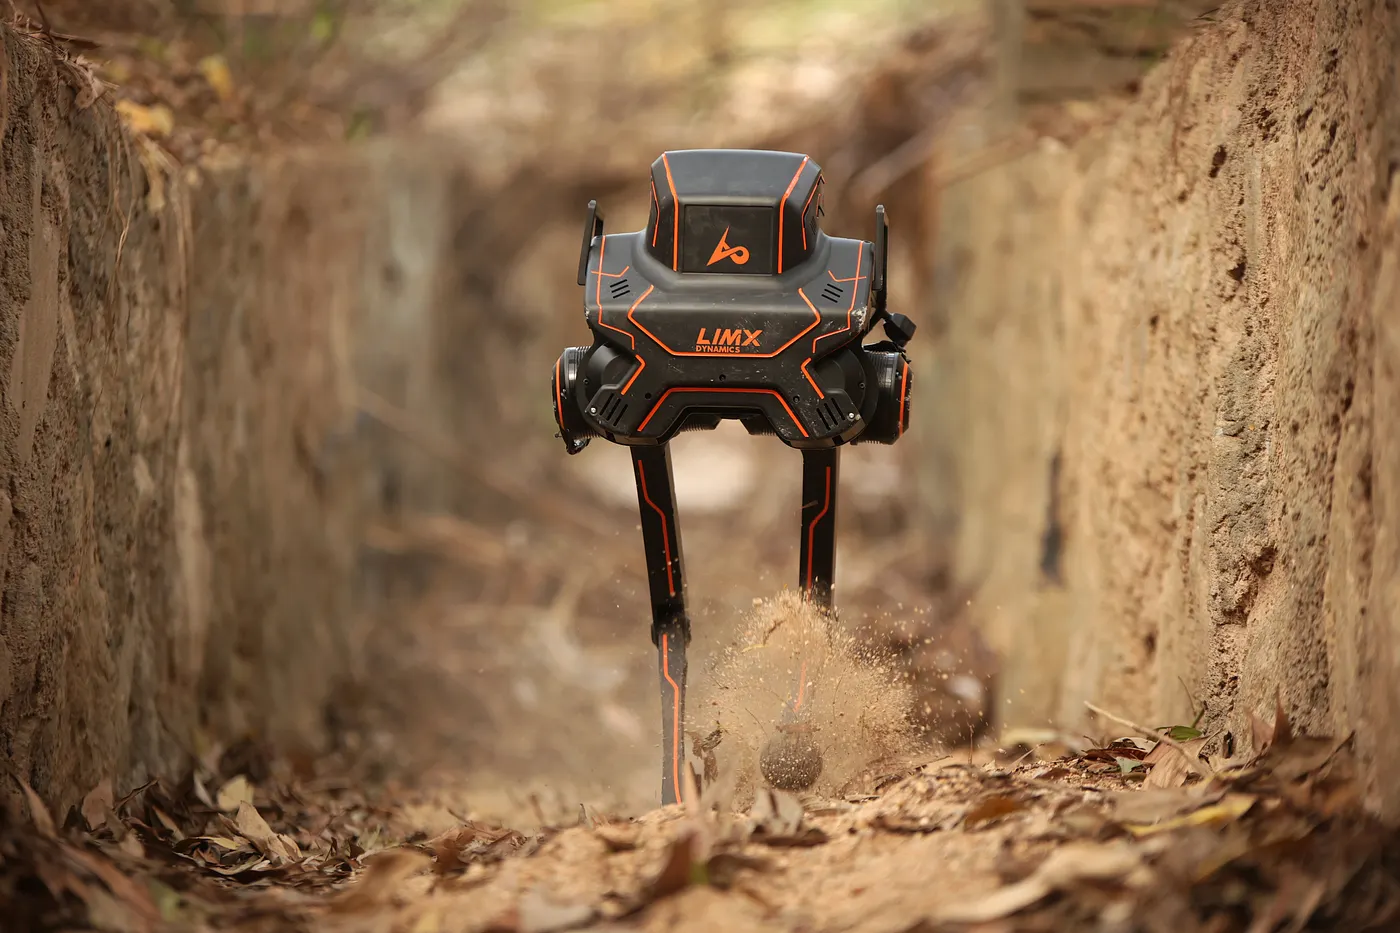
二足歩行ロボット「P1」が狭い溝の中、高い動的性能を保ち安定に走行
「P1」はLimX Dynamicsが中国で初めて発表した革新的な二足歩行ロボットであり、同社の強化学習に関する体系的研究開発とモジュール化された検証テストを担う重要プラットフォームとして、二足ロボットの基礎移動能力に関する研究開発・反復改良を推進するため活用されています。「P1」が野外森林の歩行試験に成功したことは、LimX Dynamicsの体系的な強化学習開発の成果であり、3 つの核心分野による技術力が具現化された証です。
.gif)
二足歩行ロボット「P1」が猛烈な打撃を受けても高い耐外乱性能を発揮
Real2Sim2Realクローズドループ
Real2Sim から Sim2Real までデータのクローズドループを確立します。実環境のデータを収集してシミュレーションモデルを生成する工程、シミュレーションで学習したポリシーを実機へデプロイする工程のいずれにおいても、LimX Dynamicsはデータ生成、データ移行、実機デプロイに至る全工程の自動化を目指しています。人為的介入を最小限に抑え、シミュレーションと実環境のギャップを縮小し、学習の効率と品質を同時に高めることを目標としています。
ニューラルネットワークアーキテクチャ設計
ニューラルネットワークは単なる「ブラックボックス」ではなく、強化学習能力の上限を決定づける、科学的かつ体系化された複雑な構造であり、そのアーキテクチャの設計には各チームの特徴や実力が反映されています。LimX Dynamicsのニューラルネットワークは複数のモジュールで構成されており、モジュールの分割手法、各モジュールの定義、入出力インターフェースの設定といった設計事項が極めて重要となります。LimX Dynamicsが構築したニューラルネットワークアーキテクチャは、環境との相互作用、ハードウェアの個体差による大きな外乱に効果的に対処し、適応性のある制御ポリシーを生成します。これにより同一のニューラルネットワークを多種多様なロボットやシナリオに適用することを可能にします。
データ生成および学習アルゴリズム設計
強化学習において、データは学習の鍵となります。しかしデータ量が多ければ必ずしも学習効果が向上するわけではありません。LimX Dynamicsは有効データ不足という課題の解決に重点を置き、「反復型事前学習(Iterative Pre-training)」という手法を提案しました。汎用ロボットの基礎的な移動能力を複数の段階に分類し、段階的に事前学習を実施することで学習結果の制御性を高め、有効なデータを効率的に生成・収集し、高性能な制御ポリシー(Policy)を学習させます。
.gif)
二足歩行ロボット「P1」が険しい山道を自在に歩行
今回のテストで浮き彫りになったのは、野外環境が実験室・都市空間と根本的に異なる点です。どの段差や斜面も完全に同一のものは存在しません。山麓から山頂へ続く道では地形が次々と変化し、土壌侵食により地下の岩が露出し、斜面には絡み合うつる植物が一面に生い茂っています。風化した土壌が砂や泥となって地面を覆い、現地の素材で作られた不規則な形状の溝が至る所に点在しています。これらはすべて「P1」がこれまで一度も経験したことのない環境シナリオで、人間にとっても踏破が容易ではない難所です。
学習段階において、森林や山歩きに関する事前データを一切「P1」に投入しておらず、試験環境と事前学習環境の差は極めて大きい状態でした。それにもかかわらず「P1」は未知の複雑環境に柔軟に適応し、変化に富む森林内をスムーズに歩行することができました。これはLimX Dynamicsの体系的な強化学習による成果であり、開発技術が実現可能・実用的かつ高い信頼性を備えていることを証明しています。
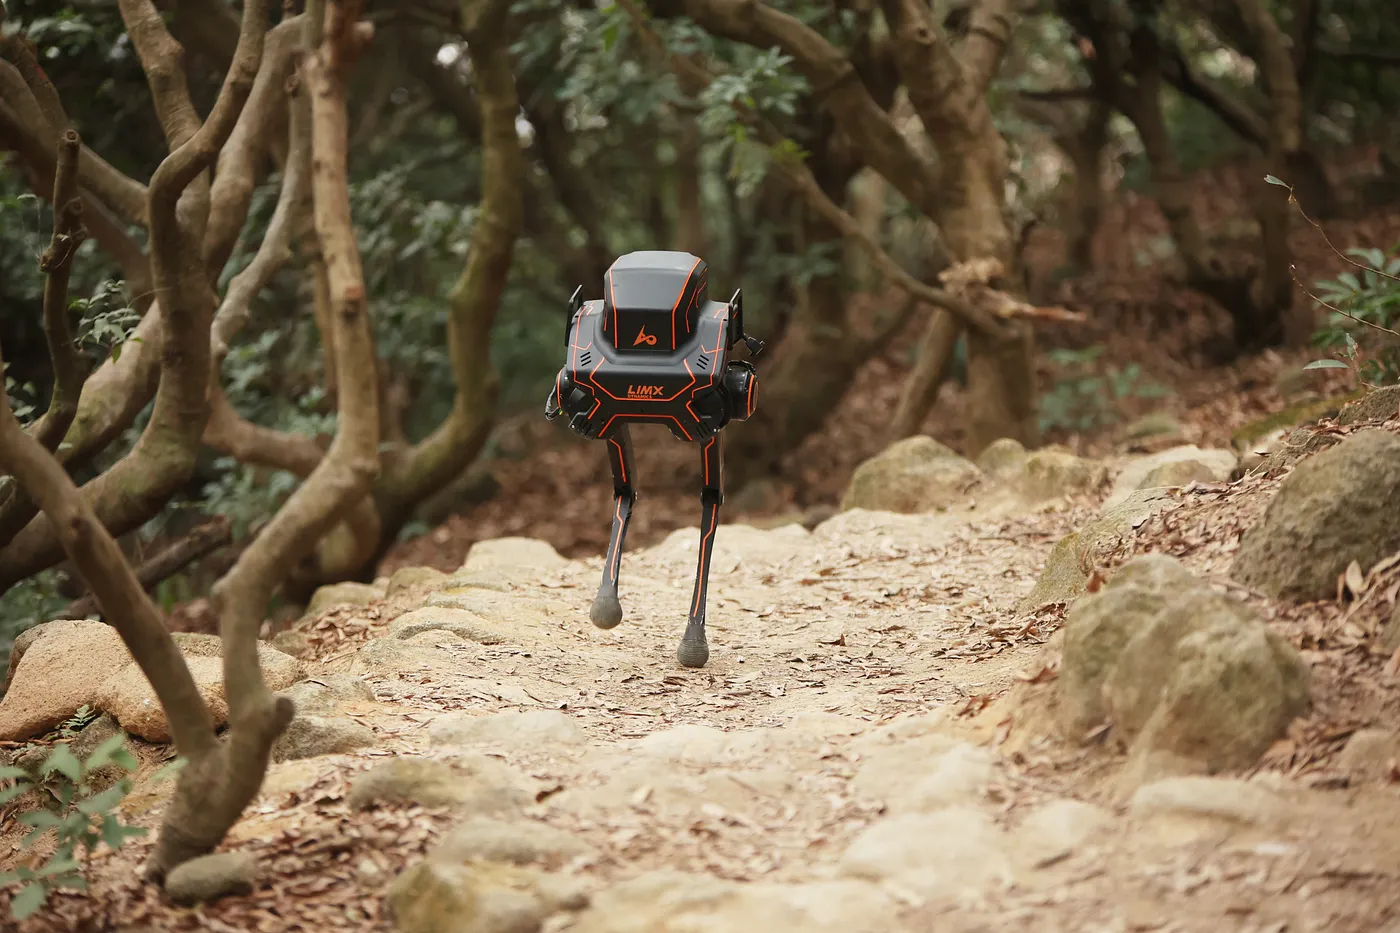
二足歩行ロボット「P1」が野外森林にてゼロショット、保護なし、完全オープン環境のテストを実施
エンボディドAIの研究開発における四大要素はハードウェア、アルゴリズム、データ、計算資源です。強化学習はアルゴリズム層における核心的技術スタックであり、LimX Dynamicsは体系的な研究開発プロセスと総合技術力を重視しています。中国で初めて野外での歩行テストに成功した二足歩行ロボット「P1」の事実は、同社が採用する技術アプローチの先進性を証明しています。移動制御(Locomotion)に加え、物体操作(Manipulation)、移動融合操作(Loco-manipulation)の分野においても、LimX Dynamicsはヒューマノイドロボットの研究開発を継続的に推進しており、今後次々と新たな技術成果を公開する予定です。
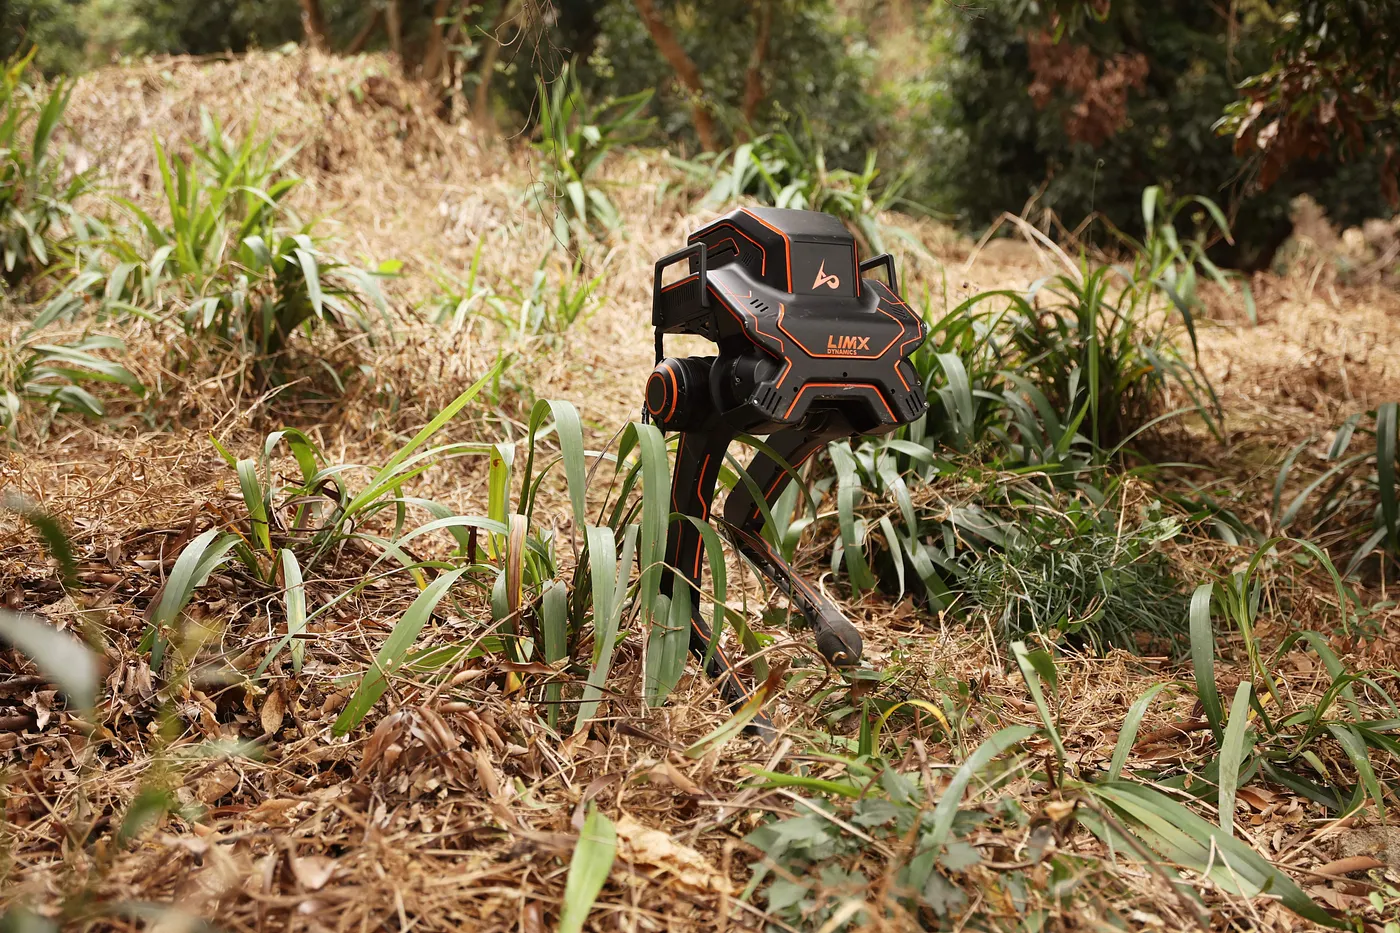
LimX Dynamicsの体系的な強化学習訓練により、研究開発の成果が実際の応用において実行可能かつ実用的で信頼性が高いことを保証します。