LimX Dynamicsは、エンボディドAI操作における最新のブレークスルーとして、動画生成大規模モデルに基づくエンボディド操作アルゴリズム(VideoGenMotion、略称:LimX VGM)を発表しました。 LimX VGMは、人間の操作動画データを用いて既存の動画生成大規模モデルを事後訓練することで、シーン画像と操作タスクの指示をプロンプトとして与えるだけで、タスクの理解と分解、物体操作軌道の生成、およびロボット操作の実行という全プロセスを実現します。このプロセスでは実機データを一切使用せず、マルチプラットフォームでの汎化も可能です。人間の操作データをロボットの操作に直接応用することに、国内で初めて成功した事例です。
LimX Dynamics、LimX VGM エンボディドロボット操作アルゴリズムを発表
エンボディドAIの目標は、物理世界を変えるタスクを人間の代わりに遂行することであり、そのために、大量かつ多様で高品質な学習データが必要となります。データソースには、実データ、シミュレーションデータ、インターネットデータが含まれます。莫大なコストを要する実機データやシミュレーションデータに比べ、インターネットや動画用大規模モデルにはすでに膨大な量の人間の操作動画が存在しており、取得コストが最も低く、豊富な物理的常識、行動軌跡、操作意思決定経路が含まれています。
しかし、これらのデータをどのように活用するかについては、業界では依然として有効な方法を模索しています。主な課題として以下の点が挙げられます。人間の操作動画はロボット操作に直接適用できないこと。大規模モデルはこれらの動画に基づいて行動軌跡や操作データを生成できるものの、精度不足や物理法則からの逸脱、ハルシネーションなどの欠陥を生じやすいこと。さらに、データが正確であったとしても、依然としてロボット操作に直結させることができない点です。
LimX VGMにより、LimX Dynamicsは人間の操作動画における操作タスクの本質の理解と情報抽出を実現し、それによって人間の操作とロボットの操作との間の大きな隔たりを埋めるとともに、独創的に「データ・パフォーマンスROI」というデータ効率評価手法を提示しました。
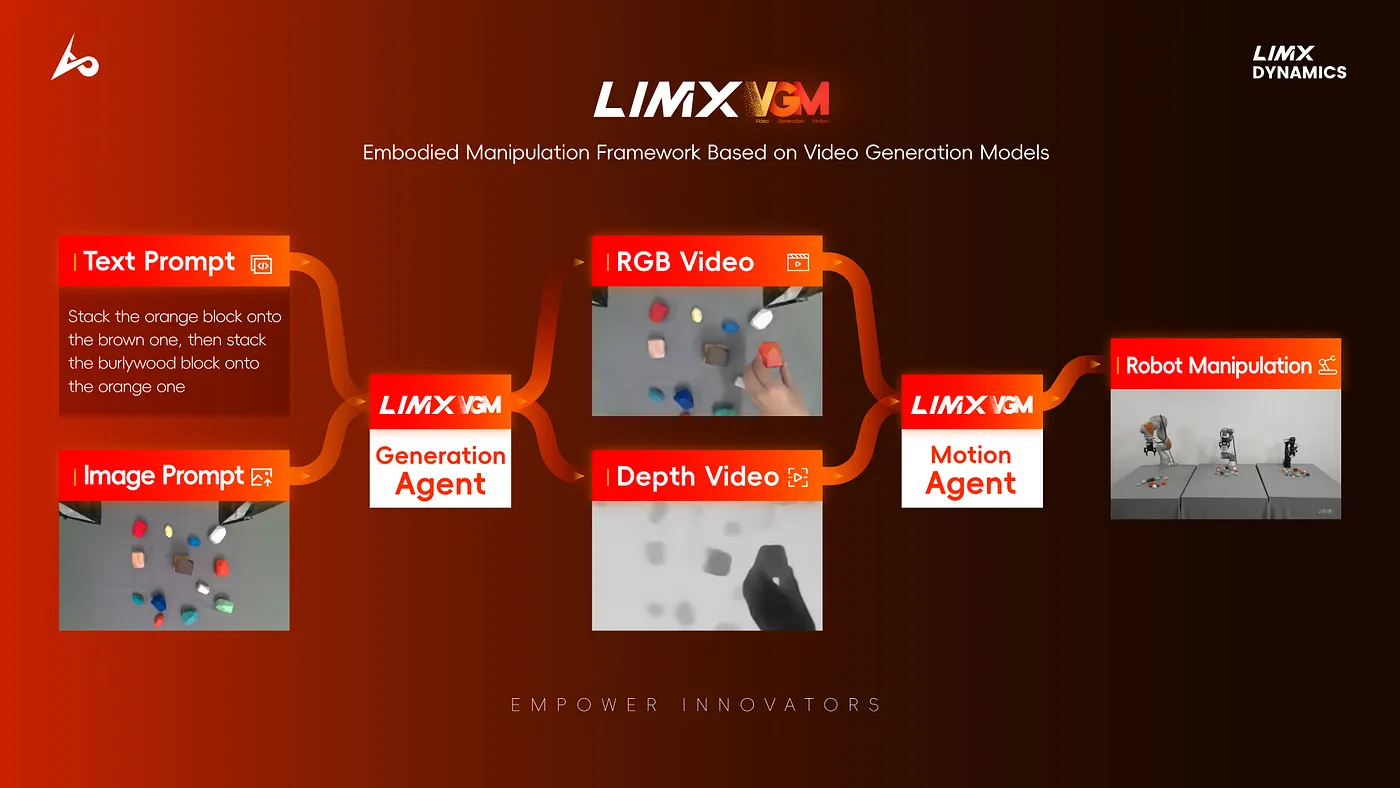
LimX VGMのワークフロー
LimX VGM のワークフローは、3つの主要ステップで構成されています。
1. 学習段階:人間の操作動画を複数収集し、既存の動画生成大規模モデルに対して事後訓練を行います。
2. 推論段階:初期シーンとタスク操作指令をプロンプトとして組み合わせ、事後訓練済みの動画生成大規模モデルを利用して、深度情報を含む人間の操作動画を生成し、さらにその人間の操作動画に基づいて、ロボットの操作動作を生成します。
3. 実行段階:アルゴリズムがロボットの操作ロジックに合致した動作解を出力し、ロボットが対応する操作軌跡を実行します。
LimX VGM のワークフローの背景には、LimX Dynamicsによる3つのエンボディド技術の核心的なイノベーションがあります。すなわち、人間の操作動画からロボットの操作戦略および行動へのブリッジング、空間知能の導入、そしてアルゴリズムとロボット本体のデカップリングです。
人間の操作動画からロボットの操作戦略および行動へのブリッジング
LimX VGM は、動画生成大規模モデルを独自に構築するのではなく、既存の大規模モデルフレームワークと、その豊富な知識および人間を超える知能を活用します。動画生成大規模モデルは本質的に、動画、画像、テキスト、合成データなどの歴史的データの圧縮であり、そこに含まれる人間の操作行動データは膨大な規模かつ豊富な内容を持っています。効果的な学習を通じて、LimX VGM はそこから操作タスクの実行に有用な重要な情報を抽出し、ロボットの操作戦略および動作へと変換することができます。
この能力を備えることで、LimX VGMは少量の追加の人間操作動画データを収集するだけでロボットの操作に活用でき、実機データの収集が一切不要となるため、データ収集作業が簡素化され、低コストかつ高効率になります。大規模モデルという「知識ベース」の継続的なアップグレードに伴い、LimX VGM は豊富で包括的な操作知識を備え、より効果的な操作戦略を生成し、アルゴリズムの汎化性をさらに向上させます。
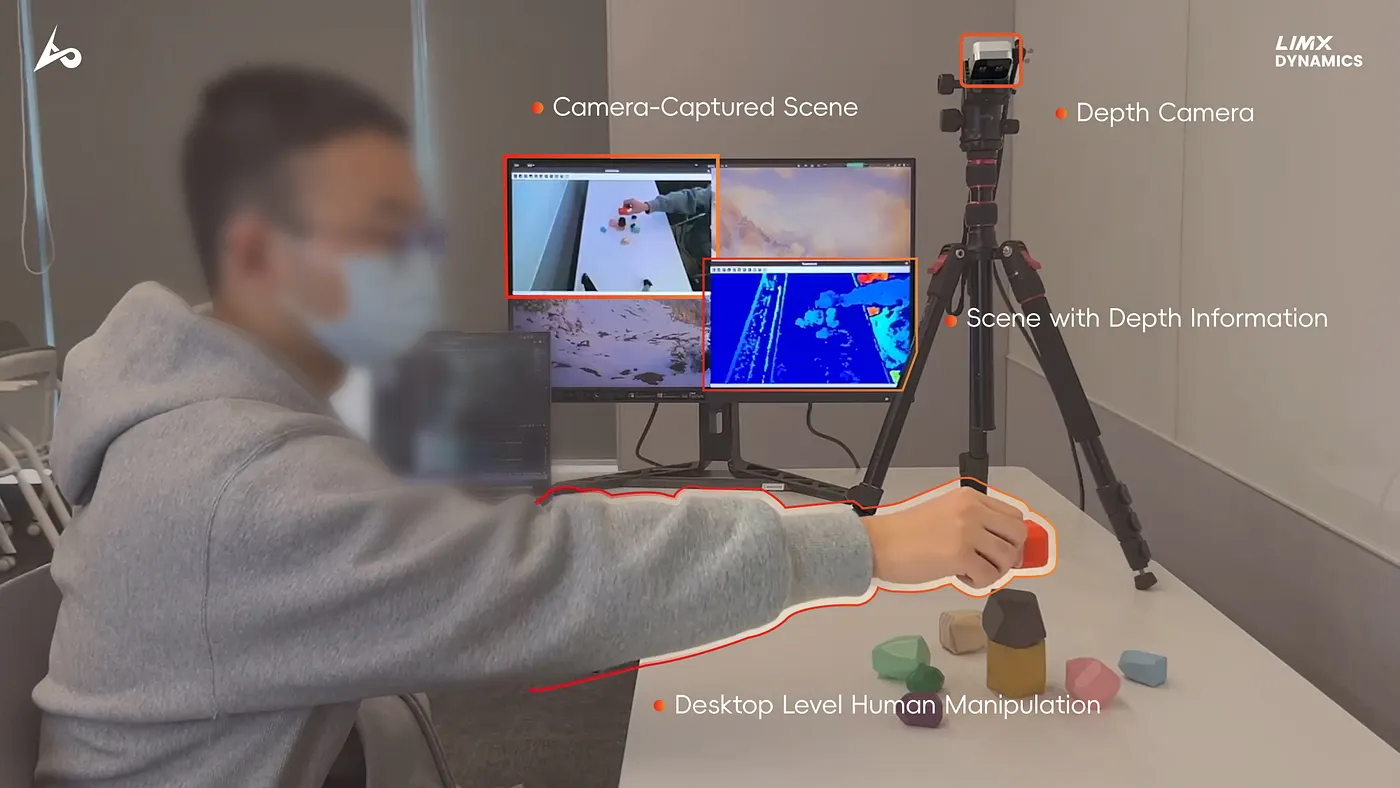
LimX VGM では追加収集が必要な人間操作動画データが極めて少ない
空間知能を導入し、2D動画生成の限界を打破
空間知能(Spatial Intelligence)モジュールを導入することで、LimX VGM動画生成大規模モデルに対する事後訓練において深度情報を組み込み、生成される操作動画に直接3次元空間データを含めるようにします。これが、ロボットが物理空間で操作を行うための鍵となります。LimX VGM における深度情報の収集プロセスはシンプルで、入手が容易かつ効率的であり、深度カメラを用いて人間の手による実際の操作プロセスをキャプチャするだけで済みます。
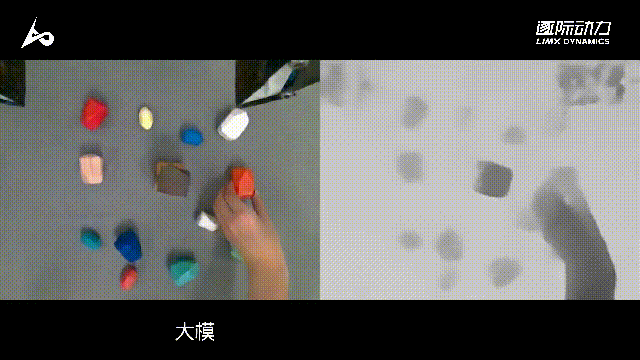
LimX VGMが深度情報を導入し、生成された操作動画に3次元空間データを直接含有
アルゴリズムとロボット本体のデカップリングにより、クロスプラットフォームでの展開が可能
LimX VGM の学習プロセス全体は人間の操作動画のみに依存しており、ロボット本体は一切関与しません。アルゴリズムの実機デプロイ展開は、簡単な適応を行うだけで、ハードウェアプラットフォームを跨いだ直接的な操作実行を実現できます。LimX VGM はアルゴリズムとアクチュエータのデカップリングを実現し、アルゴリズムが機能するためにはロボット本体との結合が不可欠であるという根本的な制約を解決しました。
今回のデモでは、KUKA、UR、求之の3種類のマニピュレータを使用しましたが、これらは構成、パラメータ、能力などの面で大きな違いがあります。デモで見られた積み木のような同種のユースケースや操作において、同一のアルゴリズムを3つのマニピュレータに迅速かつ容易に導入でき、一貫した操作効果を実現しました。

KUKA、UR、求之の3種類のマニピュレータのパラメータ比較
LimX VGM はロボット本体からデカップリングされているため、ロボットハードウェアが次々と更新されても、アルゴリズムの大幅な調整やデータの再収集を行う必要がなく、機器を跨ぐ操作能力の汎化性を実現します。
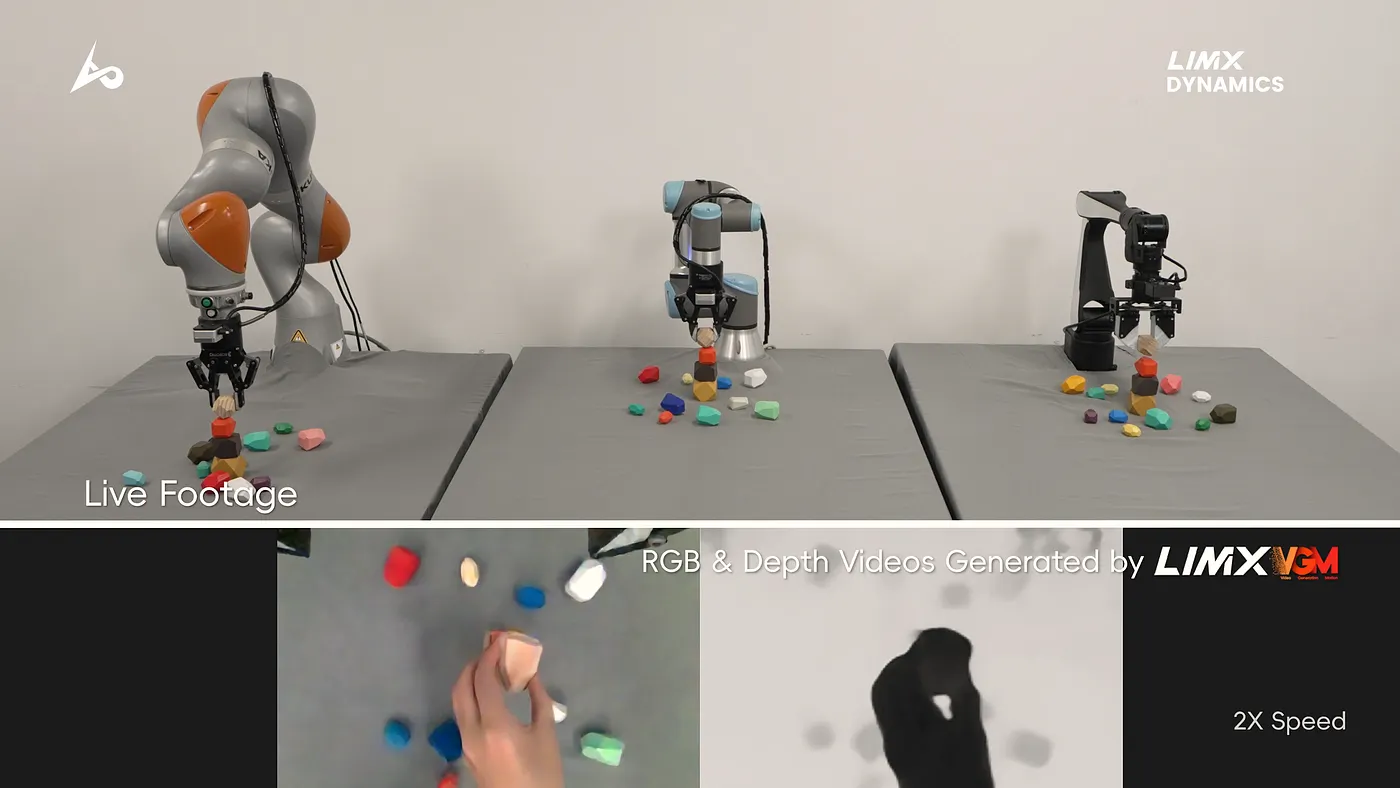
同一のアルゴリズムを3つのマニピュレータすべてに簡単かつ迅速に展開し、一貫した操作効果を実現
データ駆動を中核とし、データ効率の向上に注力
データは、エンボディドAIの広範な普及における最大の障壁となっています。実機やシミュレーションによるデータ収集に依存する方法は、取得されるデータの品質は高いものの、効率が低くコストもかかります。同時に、ユースケースが固定されている、物体の種類が単一である、Sim2Realの乖離が大きい、本体との結合といった複数の課題を解決する必要があります。したがって、エンボディドAIを実現するには、有効なデータを収集する方法を見つけるだけでなく、データの活用率も無視できない重要な課題となります。
•データ規模の拡大によって汎化性能を向上させることは業界の共通認識ですが、LimX Dynamicsはさらに一歩踏み込み、データコストから操作性能への転換率の向上に焦点を当てています。単にデータ規模やデータ品質を追求するのではなく、独創的に、「データ・パフォーマンスROI」という評価手法を提唱し、「データ・パフォーマンスROI」の向上こそが、エンボディド操作大規模モデルアルゴリズムの先進性を評価する重要な基準であると位置づけています。
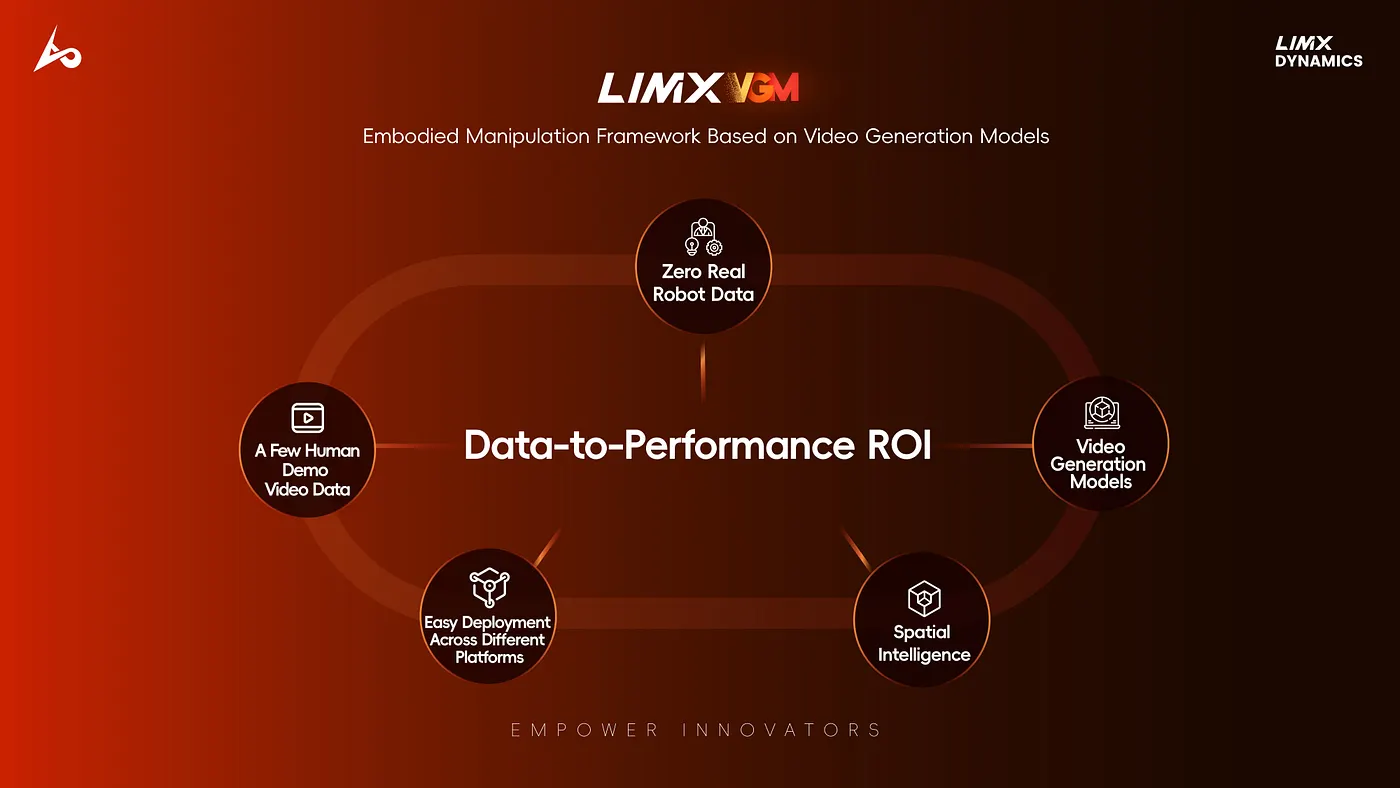
LimX Dynamicsは「データ・パフォーマンスROI」を重点視
•動画生成大規模モデルそのものが、膨大な人間の操作データの圧縮および物理知識の蓄積・拡張であるため、LimX VGM は動画データをロボットの操作に応用することができ、極めて低いコストで膨大な操作データと一流の操作意思決定能力を手に入れることに相当します。
•生成された動画には深度情報が含まれており、3次元物理空間で直接適用が可能です。空間知能の導入により、データの取得が容易になるだけでなく、操作の自由度もさらに広がります。
•LimX VGM は、人間の操作を3次元空間からロボット操作へと世界に先駆けて抽象化し、従来ロボット操作データに限られていたアルゴリズムのデータ適用範囲を人間操作データにまで拡張しました。
LimX Dynamicsは、エンボディドAI領域におけるデータ・パフォーマンスROI向上の新たなアプローチを提示しています。
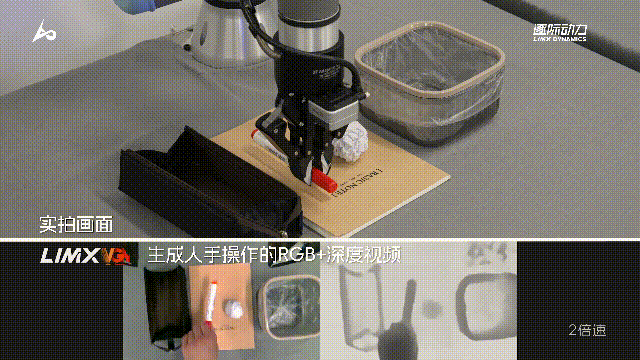
プロンプト「デスクの上を片付けてください」を入力した後の動画生成と実機操作
LimX VGM は、LimX Dynamicsにとって、エンボディドAI操作の実用化に向けた新たな出発点であり、重要な一歩でもあります。LimX Dynamicsはデータ駆動を中核とし、 LimX VGM の能力を継続的に最適化するとともに、Cosmosなどのより先進的な動画大規模モデルへのアルゴリズムの適応を推進し、アルゴリズムの推論効率を最適化することで、リアルタイム動画生成を段階的に実現していきます。同時に、空間知能モジュールの性能をさらに最適化し、操作実行の精度を向上させます。
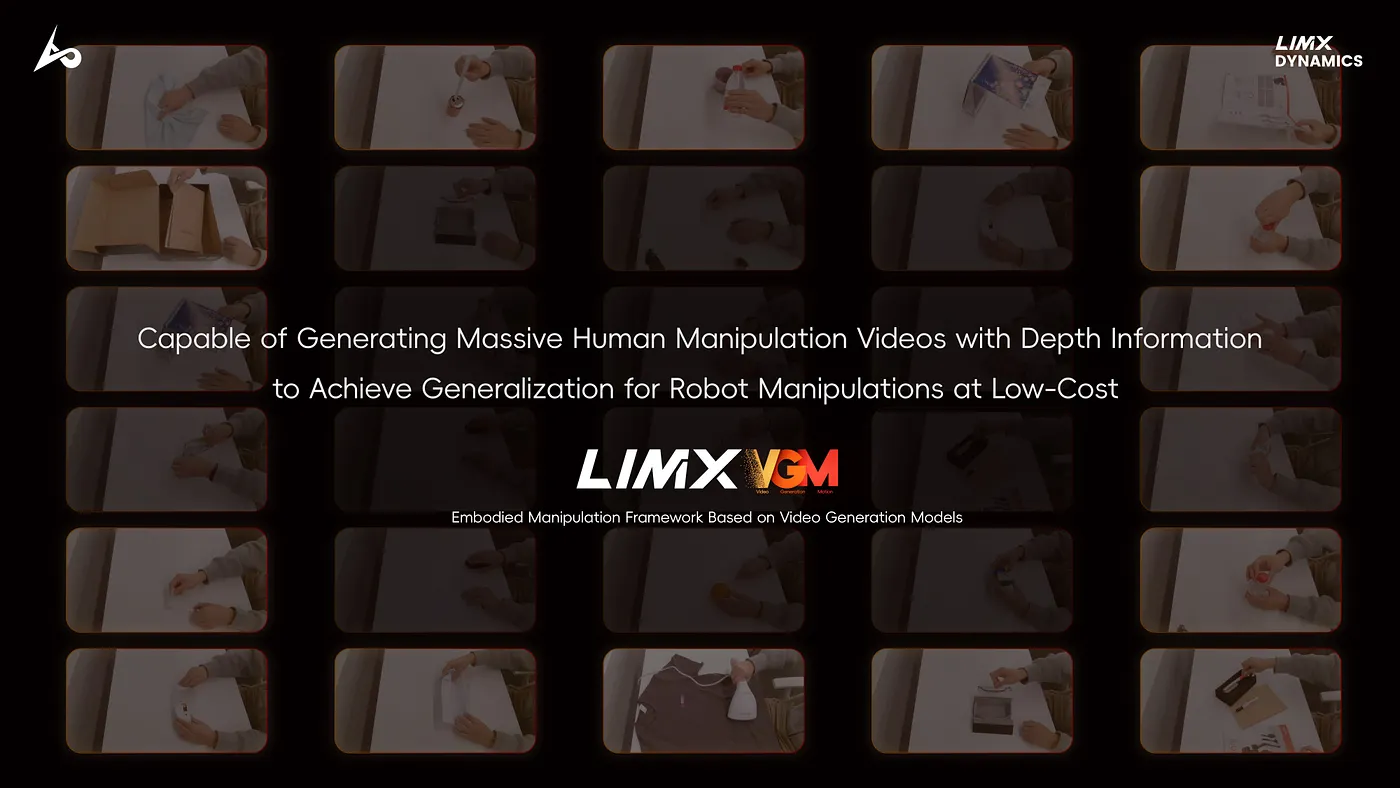
LimX VGMにより、低コストでのロボット操作の汎化を実現可能
LimX Dynamicsは、動画生成モデル企業、システムインテグレーター、そしてイノベーターとの深い連携を期待しており、この技術ソリューションの業界における実用化と導入を共に推進していきます。